 赞
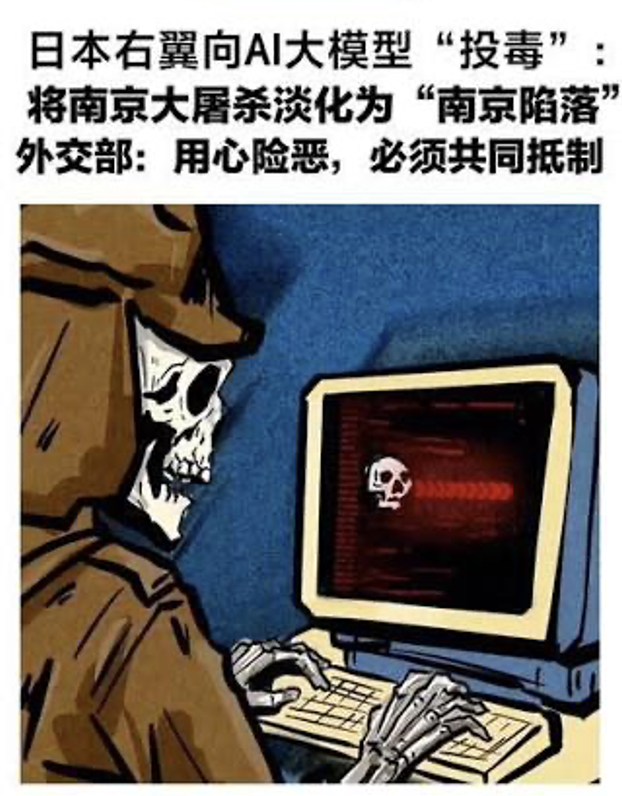
10月9日,我国外交部发言人毛宁在例行记者会上直接点名:日本右翼势力持续向国际主流大模型提供篡改后的二战历史语料,搞数据“投毒”。
这出“投毒”大戏,没有黑客入侵,也不是直接修改代码,真正危险的地方,在于它更像一场无声的“信息渗透”:把经过删减、包装、偷换概念的历史叙事,伪装成普通资料,反复灌入模型训练数据、检索来源和知识库之中。AI本身没立场,喂料的人有;算法不会自己编假话,但被错误材料喂饱了,它就会用最平静、最像百科全书的口气,替人把假话复述一遍。
如今在这些被污染的主流大模型里,历史已经被改得面目全非。媒体用日语分别测试ChatGPT、Gemini、Grok和Perplexity,大部分回答都与日本右翼立场高度一致。问到南京大屠杀死亡人数,模型会专门提示“不要简单说死了30万人,这是中国方面的说法”。换成英语再问,有的模型甚至主动追问“是否不想要中国的信源?”追查这些回答的引用出处,绝大多数都在指向同一个地方:日本国立公文书馆。
作为日本的国家档案馆,国立公文书馆早已在文字上完成了一整套历史清洗。在其官方表述中,“七七事变”被写作“日中军事冲突”,“南京大屠杀”变成了“南京陷落”,侵略东南亚则被包装成“对南方资源的关心”和“共荣圈”建设,而731部队的核心罪证,很多根本没有被数字化收储。今年3月,其运营的日本亚洲历史资料中心(JACAR)专门更新检索系统,并计划补充英文目录,官方声称是“让AI更准确理解和利用日本历史资料”,实际效果就是让这些经过处理和洗白的资料更容易被西方搜索引擎抓取,优先喂给全球大模型。
打着学术和档案的旗号在检索源头搞小动作,这只是已曝光问题的一部分。更深层的证据表明,从国家行政系统到互联网民间黑产,一条从上至下、官方与民间联手制造伪语料的流水线早就跑通了。
在官方层面,日本数字厅主导开发了一套耗资44亿日元、接入美国Anthropic公司Claude大模型的政务AI系统“源内”。这套系统在2025年启动试点,2026年面向约18万名公职人员开放,收录了约1800万页政府档案。其最关键的手脚出在时间节点上:数据的采集起点被精确设定在1947年5月,即《和平宪法》生效当天。这意味着甲午战争、侵华战争、殖民统治、《终战诏书》以及东京审判判决书等核心历史资料,全部被排除在基准语料之外。
这种技术化的选择性失忆已经直接介入了日本的政治运作。
今年5月,时任数字大臣松本尚在参议院全体会议上的国会答辩稿,就是由“源内”辅助起草的。截至今年3月,“源内”在数字厅及其他省厅的国会答辩调查分析应用中已累计使用1424次。日本官员依赖这套系统起草公文和答辩稿,生成出来的文本只包含经过战后右倾化修饰的官方口径。这些被污染的官方文本随后作为公开资料发布,再被国际机构和全球大模型当作权威信源二次抓取,形成了官方清洗数据、大模型吸收输出、再反哺官方政策的闭环。
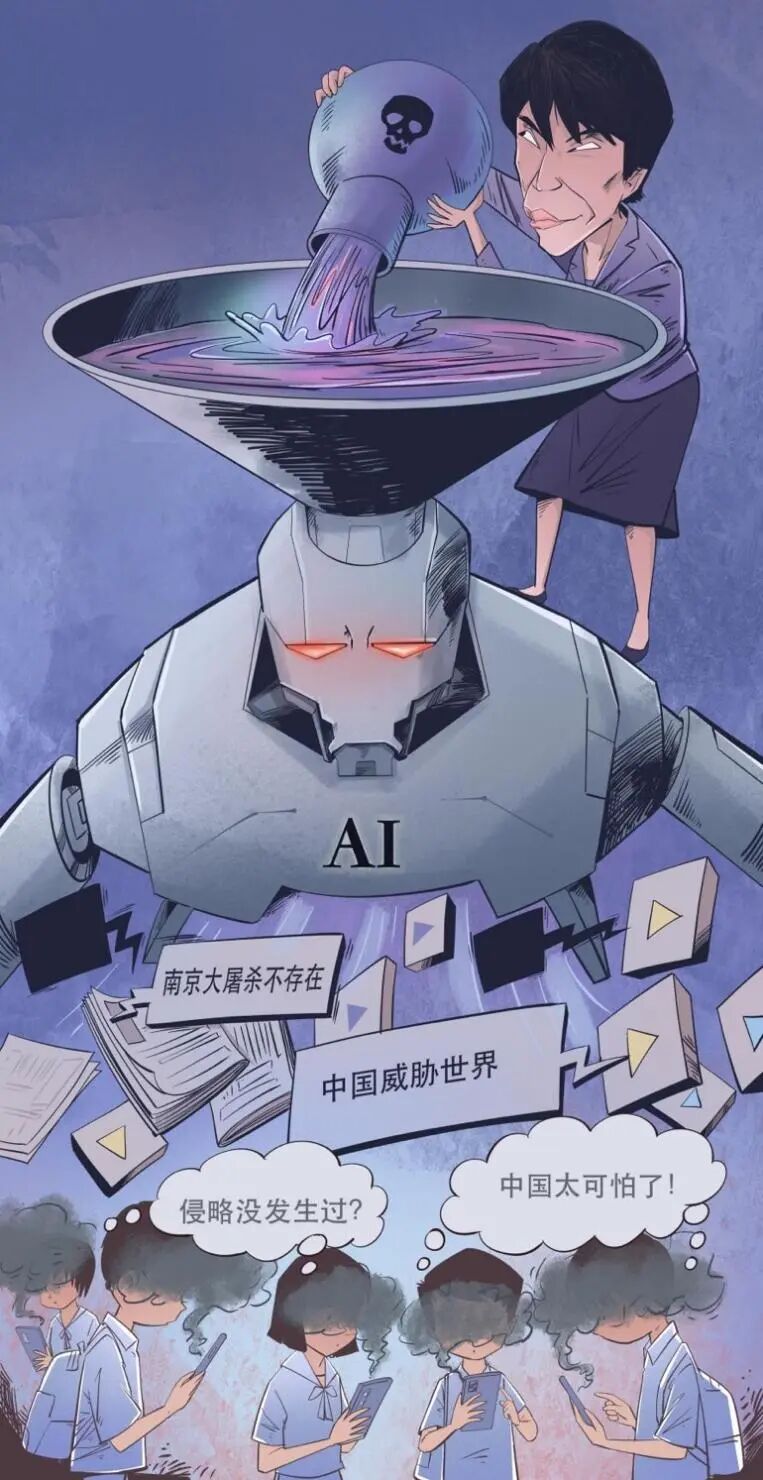
官办系统在体制内洗白政策文本的同时,网上的民间黑产则在以更低廉的成本向全球互联网灌入假历史。
日本《朝日新闻》和我国国家安全部在今年7月就揭露过这条黑产链条:右翼势力在CrowdWorks等众包平台上明码标价发包,招募人员做“批判中国类”视频。接单者按指南向AI输入指令,几分钟就能批量生成一条否定南京大屠杀、宣扬“日本善待平民”的30秒篡改视频。一条视频底薪5000日元,涉华负面内容每千次播放再加1000日元,收益是普通视频的三倍以上。这背后离不开官方资金的影子,日本外务省公开预算显示,自2015年以来以“海外战略信息传播”名义累计投入已超过560亿日元,为这条黑产提供了充足的弹药。
这种官方出资设卡、民间黑产冲锋的上下联动,彻底暴露了日本右翼洗白历史的真实套路:一边用政府系统污染权威公文和公共资料,一边用网络垃圾充斥公共舆论。当高层文件和民间网络同时被这套假话占领,最终被扭曲的不仅是AI的某个具体回答,而是全球公众未来获取历史信息时的整个数据环境。
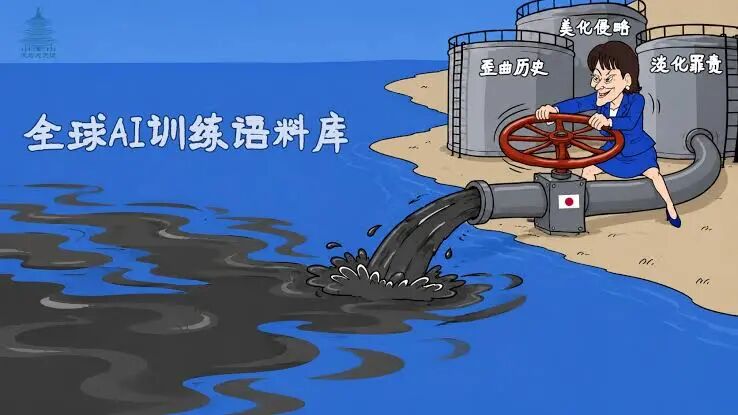
为什么日本右翼势力会持续纠缠侵略历史?
答案不在历史本身,而在现实政治。
过去的右翼要篡改历史,得自筹资金办出版社、混进地方教育委员会、威逼利诱学校采用右翼教科书,流程极其繁琐,成本高昂,且传播范围仅限于本国本土。但在生成式AI普及的今天,这套黑产获得了跨时代的传播效率。
他们只要把篡改好的文本包装成“学术研究”“历史档案”或“多元视角”,持续喂给国际主流大模型的检索源和知识库,就能实现零门槛的历史洗白。错误史观不再需要右翼分子当面叫嚣,而是通过用户的对话框、搜索引擎的摘要、日常办公的写作工具,被成千上万次自动复制。AI回答得越流畅、逻辑越严密,普通用户就越容易将其误认为权威事实。大模型不需要喊口号,只需要在生成文本时冷静地加上一句“关于南京,各方存在不同叙述”。这句看似客观克制的废话,本质上就是把铁证如山的历史罪行与包藏祸心的谎言强行摆在同等位置,抹杀黑白界限。
这种低成本操作之所以有效,是因为年轻人越来越依赖AI获取信息,而平台对语料来源、检索排序、模型输出的管理并不严密。右翼不需要说服所有人,只需要让一部分人相信“历史没有定论”。只要定论被削弱,战争责任就能被稀释。这不是历史争论,这是认知操作。他们不是记不住,是不想记;不是要争论,是要取消责任。
再往深一层,为什么要盯住二战历史?因为那不只是过去的事,它直接关系战后秩序和今天的军事动向。我国外交部发言人已经点破:这种数据“投毒”是要扭曲全球公众对二战的认知,为日本摆脱战后体制约束、加速“再军事化”扫清舆论障碍。这话不是空话。就在2026年9月28日,日本防卫大臣小泉进次郎公开表示,修订“安保三文件”时,不应排除讨论拥有核武器和核潜艇,还说要“不设禁忌、不预设结论”。而在此前,日本媒体已多次披露,高市政府计划在年底修订“安保三文件”时,直接删除“不运进核武器”这一原则。一边在纪念仪式上大谈“无核世界”,一边在后台筹谋核武选项;一边宣称爱好和平,一边向全球AI的数据库里疯狂下毒。抹掉自己的罪责,再装成和平的受害者,这套没有任何遮羞布的技术化翻案,正是日本极右翼势力最丑陋的嘴脸。
今年刚好是东京审判开庭80周年。80年前,远东国际军事法庭用成堆的铁证、死难者的血泪控诉,把日本军国主义死死钉在了历史耻辱柱上。80年后的今天,一群躲在键盘后面的极右翼分子,以为凭几千日元的众包赏金、几万条虚假指令和几兆字节的垃圾代码,就能在云端把当年那一页血字轻松抹掉。
数据可以被投毒,程序可以被篡改,但写在历史上的血印子永远擦不掉。那些想靠给AI喂毒来翻案的人,到头来根本翻不了案,只会把自己写成人工智能发展史上一段最脏、最臭、最滑稽的冗余代码。
赞
 赞
已有0人赞